ดึงข้อความจาก PDF

ดึงข้อความจากหน้าที่เลือก ตรวจผลและดาวน์โหลด TXT แบบ UTF-8 โดยไม่ทำ OCR กับภาพสแกน

ไฟล์ที่รองรับ: PDF · 1 ไฟล์ ไม่เกิน 100 MB

ตัวอย่าง: 1,3-5 เว้นว่างเพื่อเลือกทุกหน้า

  • ฟรี
  • ไม่ต้องสมัคร
  • ไม่อัปโหลดไฟล์

ตัวอย่างผลลัพธ์

ตัวอย่างผลลัพธ์: ดึงข้อความจาก PDF (ต้นฉบับ)PDF
ต้นฉบับ · journal-cover.pdf344.0 KB · 1 หน้า
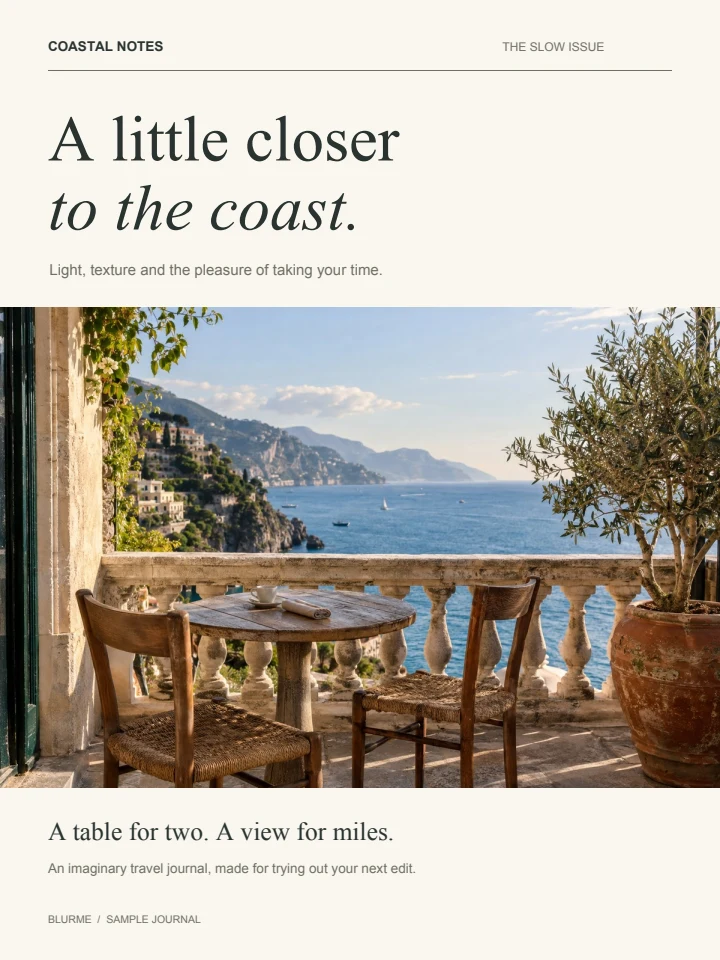
COASTAL NOTES THE SLOW ISSUE
BLURME / SAMPLE JOURNAL
A little closer
to the coast.
Light, texture and the pleasure of taking your time.
A table for two. A view for miles.
An imaginary travel journal, made for trying out your next edit.
ผลลัพธ์ · pdf-to-text-1.txt0.2 KB

อ่านชั้นข้อความเดิมของ PDF

  1. เลือก PDF ที่มีข้อความที่เลือกได้

  2. ดูข้อความที่ดึงออกมาในตัวอย่าง

  3. ดาวน์โหลดไฟล์ TXT

ผลลัพธ์ขึ้นอยู่กับข้อมูลข้อความภายใน PDF

การแปลง PDF เป็นข้อความล้วนจะตัดแบบอักษร รูปภาพ และการจัดหน้าออก เหลือเพียงตัวหนังสือที่ย้ายไปใช้ในโปรแกรมแก้ไขอื่นได้ง่าย

หลายคอลัมน์ ตาราง ฟอนต์พิเศษ หรือการจับคู่ตัวอักษรที่ขาดหายอาจเปลี่ยนลำดับ หากบางหน้าว่างหรือเป็นสแกนแต่หน้าอื่นมีข้อความจะแสดงข้อความแจ้ง

ไฟล์ที่รองรับ

PDF → TXT

  • 1 ไฟล์ ไม่เกิน 100 MB
  • ขนาดนำเข้ารวม: 300 MB
  • ขนาดส่งออกรวม: 150 MB
  • หน้า: ≤ 200

ไม่รองรับ PDF เข้ารหัส ไม่แก้ข้อความเดิมหรือทำ OCR

คำถามที่พบบ่อย

ทำไม PDF สแกนจึงดึงข้อความไม่ได้?

ไฟล์อาจมีเพียงภาพของตัวอักษร เครื่องมืออ่านชั้นข้อความที่มีอยู่ ไม่รู้จำตัวอักษรในภาพ

การดึงข้อความ PDF สร้างตารางกลับเป็นสเปรดชีตได้หรือไม่?

ไม่ได้ ผลเป็นข้อความล้วน ไม่สร้างเซลล์ คอลัมน์ หรือโครงร่างตารางใหม่

ตัวอักษรไทย เกาหลี ญี่ปุ่น และอาหรับใน PDF จะคงอยู่หรือไม่?

UTF-8 รองรับ แต่การดึงขึ้นกับข้อมูลจับคู่ตัวอักษรใน PDF โปรดตรวจตัวอักษรที่หายและลำดับ

ดึงข้อความ PDF ตามลำดับหน้าอื่นได้หรือไม่?

ได้ 3,1-2 จะอ่านหน้าสามก่อนหน้าแรกและหน้าสอง โดยไม่เปลี่ยนลำดับการอ่านภายในหน้า

ไฟล์ของฉันถูกอัปโหลดไปยังเซิร์ฟเวอร์หรือไม่

ไม่ ไฟล์จะถูกประมวลผลในเบราว์เซอร์บนอุปกรณ์นี้ และไม่ถูกส่งไปยังเซิร์ฟเวอร์ของ BlurMe

เครื่องมือที่เกี่ยวข้อง

เครื่องมือทั้งหมด

ตรวจสอบและปิดบังข้อมูลส่วนบุคคลในเอกสารด้วย BlurMe

ต้องมีบัญชีฟรีเพื่อดาวน์โหลด ไฟล์ที่ส่งออกฟรีจะมีลายน้ำ