PDFからテキスト抽出

指定したPDFページのテキストを抽出し、確認してUTF-8のTXTを保存できます。スキャンOCRは行いません。

対応ファイル: PDF · 1ファイル・100 MBまで

例:1,3-5。空欄で全ページを選択します。

  • 無料
  • 登録不要
  • アップロード不要

結果の例

結果の例: PDFからテキスト抽出 (元データ)PDF
元データ · journal-cover.pdf344.0 KB · 1 ページ
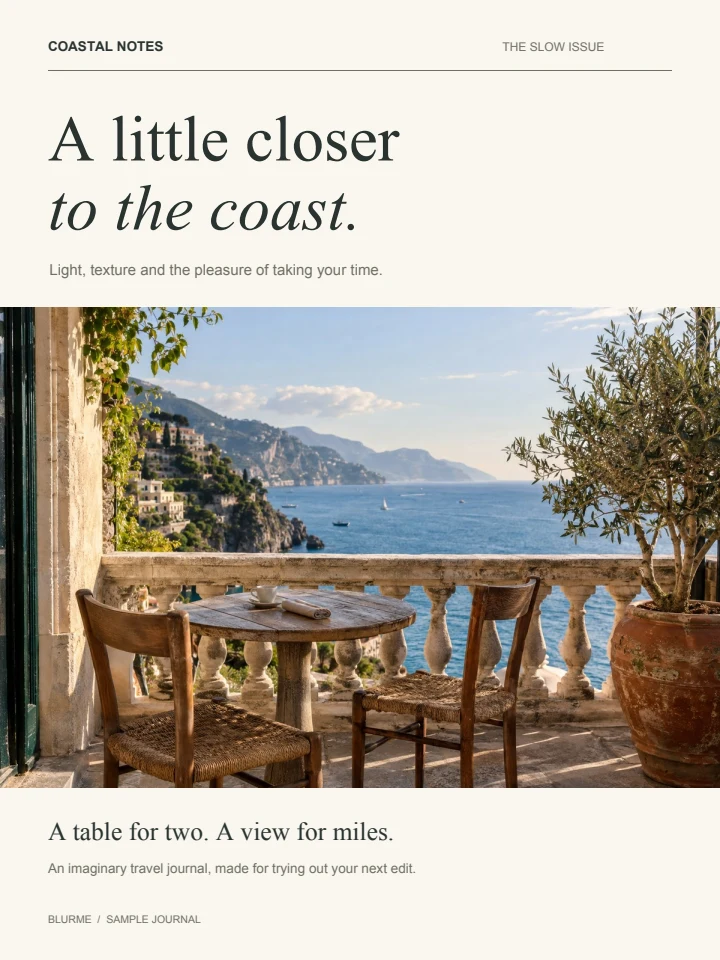
COASTAL NOTES THE SLOW ISSUE
BLURME / SAMPLE JOURNAL
A little closer
to the coast.
Light, texture and the pleasure of taking your time.
A table for two. A view for miles.
An imaginary travel journal, made for trying out your next edit.
結果 · pdf-to-text-1.txt0.2 KB

PDFのテキスト層を取り出す

  1. 文字を選択できるPDFを選びます。

  2. 抽出したテキストをプレビューで確認します。

  3. TXTファイルをダウンロードします。

PDF内部の文字情報に基づく抽出

PDFをプレーンテキストにすると、フォント・画像・レイアウトがなくなり文字だけが残るため、別のエディターに移しやすくなります。

段組み・表・特殊フォントでは表示順と抽出順が異なることがあります。一部が白紙やスキャンなら部分抽出の通知を表示します。

対応ファイル

PDF → TXT

  • 1ファイル・100 MBまで
  • 入力合計: 300 MB
  • 出力合計: 150 MB
  • ページ: ≤ 200

暗号化PDFには対応していません。既存テキストの編集やOCRは行いません。

よくある質問

スキャンPDFから文字が見つからないのはなぜですか?

文字に見えても画像だけの場合があります。このツールは既存のテキスト層を読み、画像の文字は認識しません。

PDFの表をテキスト抽出で表計算に復元できますか?

プレーンテキストだけを出力し、セルや列は再構成しません。

PDFから日本語・韓国語・アラビア語も取り出せますか?

UTF-8は対応しますが、PDFの文字マッピングに依存します。欠落や順番を確認してください。

PDFのテキストを別のページ順にできますか?

3,1-2なら3ページ、1ページ、2ページの順です。ページ内の読み順は変更しません。

ファイルはサーバーにアップロードされますか?

いいえ。ファイルはこの端末のブラウザー内で処理され、BlurMe のサーバーには送信されません。

関連ツール

すべてのツール

BlurMeで文書内の個人情報を確認し、墨消しできます。

ダウンロードには無料登録が必要です。無料出力には透かしが入ります。