PDF 提取文本

提取指定 PDF 页面的文本,预览后下载 UTF-8 TXT。不对扫描图片进行 OCR。

支持的文件: PDF · 1 个文件 · 最多 100 MB

例如:1,3-5。留空表示所有页面。

  • 免费
  • 无需注册
  • 无需上传文件

结果示例

结果示例: PDF 提取文本 (原始文件)PDF
原始文件 · journal-cover.pdf344.0 KB · 1 页码
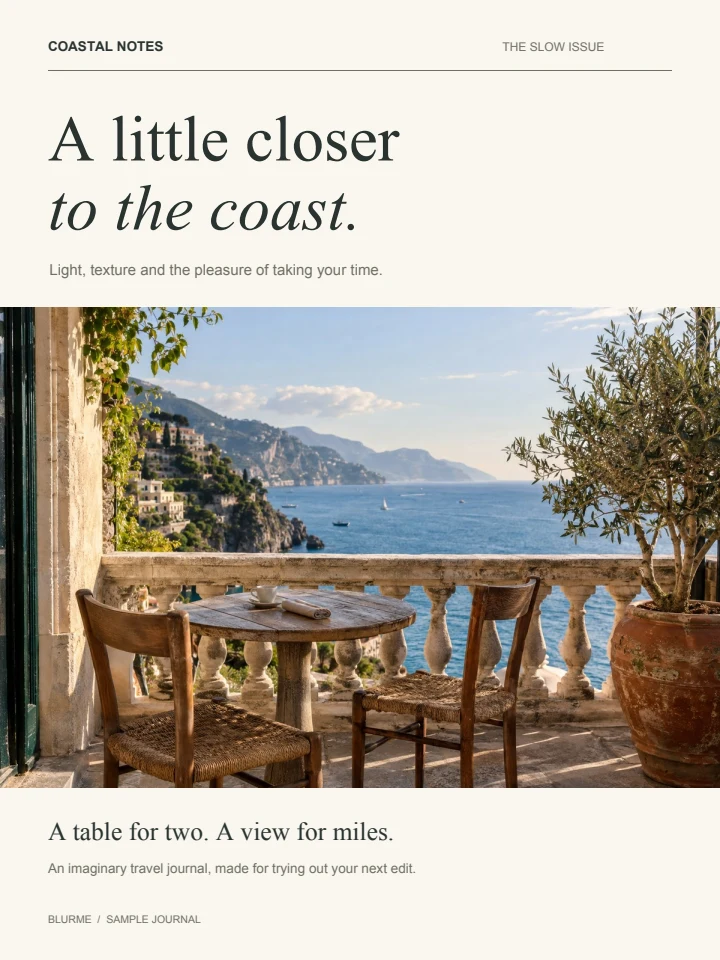
COASTAL NOTES THE SLOW ISSUE
BLURME / SAMPLE JOURNAL
A little closer
to the coast.
Light, texture and the pleasure of taking your time.
A table for two. A view for miles.
An imaginary travel journal, made for trying out your next edit.
结果 · pdf-to-text-1.txt0.2 KB

读取 PDF 文档现有的文本层

  1. 选择包含可选中文字的 PDF。

  2. 在预览中查看提取的文字。

  3. 下载 TXT 文件。

提取结果取决于 PDF 内部文本信息

把 PDF 转为纯文本会去掉字体、图片和版式,只留下文字,方便移到其他编辑器中。

多栏、表格、特殊字体或缺失字符映射可能影响顺序。若部分页面为空白或扫描图,而其他页面有文字,会提示部分提取。

支持的文件

PDF → TXT

  • 1 个文件 · 最多 100 MB
  • 输入总大小: 300 MB
  • 输出总大小: 150 MB
  • 页码: ≤ 200

不支持加密PDF。页面操作不会编辑已有文字或执行OCR。

常见问题

为什么扫描 PDF 没有提取出文本?

扫描可能只包含文字的图片。本工具读取已有的文本层,不识别图片里的字符。

PDF 文本提取能把表格还原为电子表格吗?

不能。只输出纯文本,不重建单元格、列或布局。

PDF 中的中文、韩文、日文和阿拉伯文能保留吗?

UTF-8 支持这些字符,但能否提取取决于 PDF 的字符映射。请检查缺字与顺序。

可以按其他页序提取 PDF 文本吗?

可以。3,1-2 会先处理第三页,再处理第一、二页,不改变页内阅读顺序。

文件会上传到服务器吗?

不会。文件在本设备的浏览器中处理,不会发送到 BlurMe 服务器。

相关工具

全部工具

使用 BlurMe 检查并遮盖文档中的个人信息。

下载需要免费注册。免费导出的文件带有水印。